=head1 Freenet - Informationsfreiheit ohne Zensur, aber mit Perl
=head2 Abstract
Das Freenet-Projekt (http://www.freenetproject.org) hat es sich zur
Aufgabe gemacht, jedem die die Möglichkeit freier Meinungsäußerung zu
garantieren. Neben der Implementierung einer Lösung für dieses Problem
durch das Projekt geht es in diesem Artikel darum, wie man in Perl selbst
Informationen herunterlädt bzw. veröffentlicht.
=head1 Einführung
Das Freenet-Projekt (http://www.freenetproject.org) hat es sich zur
Aufgabe gemacht, jedem die die Möglichkeit freier Meinungsäußerung
zu garantieren. Als Mittel zur Umsetzung hat es ein virtuelles Netzwerk
gewählt, in dem es nicht realistisch möglich sein wird, Einspeisung
von neuen Daten zu verhindern oder den Urheber von Veröffentlichungen
ausfindig zu machen, solange er dies nicht selbst zugibt. Darüberhinaus
ist es für Betreiber von Freenet-Knoten nicht möglich, zu wissen, was
auf ihrer Festplatte gespeichert wurde oder wo die Daten herstammen, so
daß es ab einer bestimmten Netzwerkgröße nicht mehr möglich ist,
dem Betreiber einer Freenet-Node nachzuweisen, daß er illegale Inhalte
besitzt bzw. weitergegeben hat oder davon gewusst hat.
In China beispielsweise wird eine frühe Version von Freenet für ein
rein chinesisches Freenet-Netzwerk aktiv benutzt, um politische Inhalte
verbreiten zu können, ohne Maßnahmen von der Regierung zu befürchten.
=head2 Freenet für den Benutzer
Freenet speichert nur relativ kleine Dokumente (<= 1MB) am Stück. Diese
Dokumente können beliebige Daten enthalten, z.B. HTML-Seiten. Dise
Datenblöcke können mit einem für jeden Block eindeutigen Schlüssel
abgerufen werden, z.B. in einem Web-Browser.
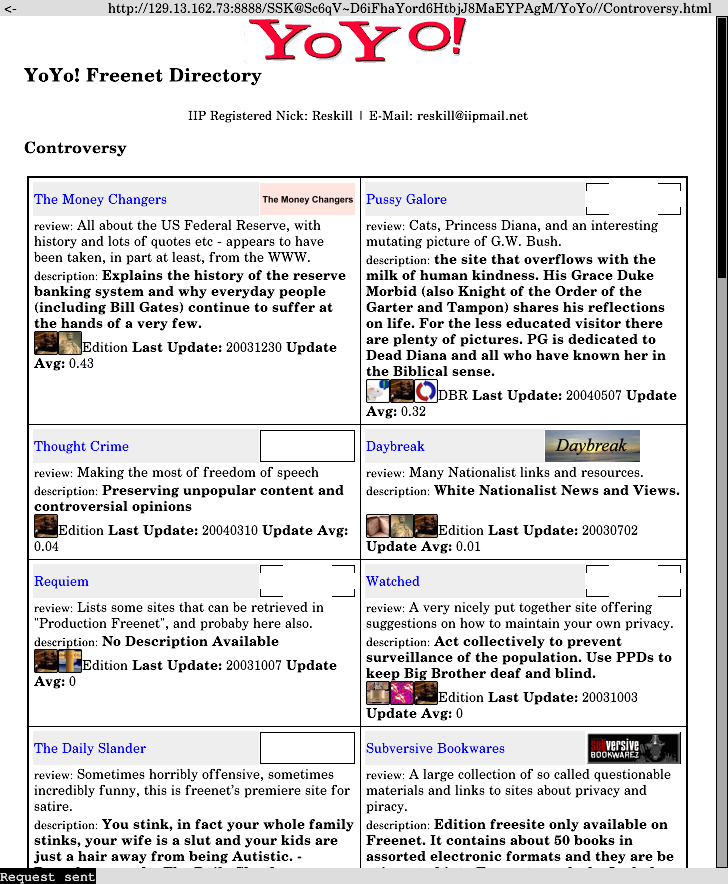
Hier ist ein Beispiel für eine solche HTML-Seite:
=for html
=for latex
\begin{center}\includegraphics[scale=0.55]{freenet1.png}\end{center}
Die hier verwendete URL ist:
http://129.13.162.73:8888/...
...SSK@Sc6qV~D6iFhaYord6HtbjJ8MaEYPAgM/YoYo//Controversy.html
C ist die Adresse meines Freenet-Daemons,
üblicherweise C, der Sicherheit wegen sollte man
immer einen eigenen Freenet-Daemon laufen lassen. Der Schlüssel der
C<">FreesiteC<"> ist C und in dieser wird
wiederum das Unterdokument C angezeigt.
Diese Seite ist Teil eines sehr bekannten Einsprungpunktes ins
Freenet. Generell bevorzugt das Freenet-Projekt keine bestimmten
Einsprungpunkte. Die Regel ist: kennt man den Einsprungpunkt nicht, findet
man die Inhalte nicht; es ist sogar unmöglich zu bestimmten, wieviel oder
welche Informationen im Freenet gespeichert sind: Ein Index a'la google
ist prinzipbedingt nicht möglich.
Obwohl es einige Freenet-Spider und Directory-Freesites gibt ist der
überwältigende Teil der Information im Freenet nicht darüber zu
erreichen.
Neben HTML-Inhalten gibt es auch Mail-, Foren- und Chat-Systeme im
Freenet.
Die Einspeisung von Daten kann von überall im Netz
geschehen. Mehrfacheinspeisung ist möglich (und meistens notwendig) und
erhöht führt nicht zur Dupliziering von Daten.
Natürlic gibts es auch einige Nachteile, die teilweise mit dem Design
und teilweise mit der Implementierung zusammenhängen. So ist der einzige
verfügbare Freenet-Daemon in Java implementiert und daher leider extrem
unportabel (läuft praktisch nur auf Linux/x86 und Windows, da das
benötige Sun-Java-JDK auf andreen Platformen nicht verfügbar oder
veraltet ist), sehr langsam und vor allem Speicherhungrig, und häufig
auch sehr instabil.
Die aktuellen Versionen des Freenet-Daemons sind alle als C<">nicht sicherC<">
deklariert, da erst die Release 1.0 verspricht, alle Ideen umgesetzt zu
haben, wovon das Projekt noch 0.5 Versionen entfernt ist :)
Designbedingt ist das Freenet eher langsam (extrem hohe Latenz,
akzeptabler Durchsatz) und für interkative Benutzung teilweise
ungeeignet, bzw. eine echte Geduldsprobe.
Durch die Art der Speicherung kann nicht garantiert werden daß
Informationen überhaupt wiedergefunden werden. C<">UnpopuläreC<"> Information
verschwindet, sofern sie nicht regelmäßig eingespeist oder abgerufen
wird, automatisch wieder aus dem Freenet.
=head2 Die Freenet-Architektur
Herkömmliche File-Sharing-Netzwerke haben zwei Große Nachteile: Entweder
sind sie nicht wirklich anonym (selbst anonymisierende Netzwerke oder
Proxies sind üblicherweise nicht vor Zugriff durch Regierungen sicher
(ein bekanntes Beispiel ist I, C, das
zwar vollmundig vollkommene Anonymität garantiert aber schoneinmal durch
die Polizei gezwungen wurde, Log-Informationenen herauszugeben, wozu die
Betreiber nach deutschen Recht verpflichtet sind). Oder sie skalieren
nicht, da sie Broadcast-Algorithmen benutzen die größere Netzwerke von
vorneherein ausschließen (bekanntes Beispiel dafür ist I).
Das erste Problem umgeht Freenet (Achtung, vereinfacht!), indem es
jeden Datenblock hasht und aus diesem Hash einen Schlüssel für die
Verschlüsselung generiert und die Daten damit verschlüsselt (sic).
Der Schlüssel wird ein zweitesmal gehasht. Dieser Hash wird zur
eindeutigen ID des Datenblocks. Diese ID und der verschlüsselte
Datenblock werden ins Freenet eingespeist. Dabei, wird immer derselbe
Key generiert (da er nur von den Daten abhängt) und der verschlüsselte
Block ist ebenfalls immer gleich. Daher kann er problemlos mehrfach und
von unterschiedlichen Parteien eingespeist werden ohne die Daten faktisch
mehrfach im Freenet abzulegen.
Das ist sicher, da ein kryptographisch sicherer Hash (der die Grundlage
des Systems bilden muß) nur in eine Richtung funktioniert: Aus der ID
(== Hash des Hashes der Daten) kann nicht auf den Schlüssel geschlossen
werden. Speichert also ein Netzknoten die Daten und die ID dazu, kann man
die Daten zwar abrufen, jedoch nicht entschlüsseln. Selbst der Besitzer
eines Knotens kann mit vollkommenen Wissen über alle Vorgänge seines
Knotens die Inhalte nicht lesen.
Eine weitere Konsequenz dieses Verfahrens ist die Tatsache, das Dokumente
niemals verändetr werden können: eine Änderung bewirkt eine Änderung
des Schlüssels und damit eine neue ID, praktisch eine völlig neue URL.
Möchte man z.B. das grüne Blatt der Freesite C<">Thought CrimeC<"> herunterladen so
wird man mit folgendem Freenet-Key konfrontiert:
CHK@pfAv9IejYPLQwaTLXDguEkUhiNUMAwI,blzDbhN~8Q28esq4JrfRWw
C steht für I, der häufigste Schlüsseltyp im
Freenet, der das oben beschriebene Verfahren benutzt. Der CHK besteht
aus zwei Teilen: der ID, unter der der Schlüssel im Freenet abgelegt
wird (C) und dem Schlüssel, mit dem die
Daten verschlüsselt wurden (C), durch ein Komma
getrennt.
Das sind übrigens (mehr oder weniger) base64-encodete Daten, dekodiert
sieht der Schlüssel so aus:
CHK@
ID = a5f02ff487a360f2d0c1a4cb5c382e12452188d50c0302
Key = 6e5cc36e137ef10dbc7acab826b7d15b
(Man kann daraus tatsächlich ablesen, das der Datenblock 4k groß (0x0c
am Ende der ID bedeutet 2**12) ist und Twofish benutzt. Aber derartige
Details überläßt man lieber einem Perl-Modul).
Nur der erste Teil wird als Anfrage ins Freenet geschickt, der zweite Teil
bleibt im lokalen Freenet-Daemon. Wird nun der Datenblock geliefert, kann
er mit dem Schlüssel dekodiert werden und wird an den Benutzer geliefert.
Das zweite Problem (der Skalierbarkeit) wird durch lineare
statt exponentielle Suche gelöst: mit jeder Anfrage wird eine
I-Angabe (HTL, ähnlich wie das TTL in IPv4)
verknüpft. Diese Zahl, die üblicherweise zwischen 5 und 25 (maximal)
liegt, gibt an, wie viele Knoten die Anfrage maximal weitergeleitet
wird. Jeder Knoten, der die Daten nicht lokal vorrätig hat, leitet sie an
denjenigen Knoten weiter, der die Daten am wahrscheinlichsten hat. Da das
Verfahren linear ist und nicht exponentiell, skaliert es ebenfalls linear
mit der Netzwerkgröße.
Lädt man das Dokument, wird man mit Metadaten und C<">normalenC<"> Daten
konfrontiert.
Metadaten:
Revision=1
EndPart
Document
Info.Format=image/png
End
Daten:
PNG^Z...
Nun stellt sich die Frage, wie man sicherstellt, daß Daten im Freenet
bleiben, da es nur endliche Speicherkapazität hat. Die Antwort ist
überraschend: Es geht nicht. Wenn ein Knoten sich entscheidet, Daten
zu löschen oder Platz für neue Daten zu schaffen, gehen zwangsläufig
andere Daten verloren. Dagegen hilft nur wiederholtes Einfügen und der
Wunsch, daß die eigenen Daten beliebt genug sind, damit sie abgerufen
werden und damit länger überleben.
Absolute Anonymität und nichtnachvollziehbarkeit von Transaktionen ist
eben nicht vereinbar mit garantierter Datenspeicherung. Könnte man
garantiert Nachweisen, das ein Dokument existiert, so wäre es für
einen Knotenbetreiber schlecht möglich, Wissen über die Art der Daten
abzustreiten, die er speichert.
=head3 SSK-Schlüssel
Der zweite gebräuchliche Schlüsseltyp, mit dem man im Freenet
konfrontiert wird, ist ein C-Schlüssel (C steht für I). Hier ist einer:
SSK@0OhVDWutibbBMbXmbxNXW0M6YFoPAgM
Zwei Dinge unterscheiden Sie von CHK-Schlüsseln:
Erstens ist ein SSK-Schlüssel eigentlich ein Schlüsselpaar, ein
Schlüssel (der private Schlüssel) muss für das Einfügen von Daten
benutzt werden, der zweite Schlüssel (der öffentliche Key) wird für
das Auslesen der Daten benutzt. Da die Daten signiert sind, kann nur der
oder die Besitzer des privaten Schlüssels Daten unter diesem einfügen,
während die Besitzer des öffentlichen Schlüssels überprüfen könenn,
ob die Daten tatsächlich mit dme richtigen Schlüssel signiert wurden.
Zweitens ist die ID, unter dem diese Date abgelegt werden, nicht von den
Daten sondern nur vom C<">NamenC<"> (dem Key) abhängig, man kann also URIs
erzeugen auf Dateien, die noch nicht eingefügt wurden.
Diese Art Schlüssel ist relativ ineffizient und kann keine großen
Datenmengen speichern (<= 32KB!), SSKs werden also vorwiegend für
Weiterleitungen auf CHKs benutzt.
Der obige SSK gehört übrigens zur C<">Freenet ExplainedC<">-Freesite, die die
einzelnen Schlüsseltypen (und mehr) erklärt. Finden kann man sie hier:
SSK@0OhVDWutibbBMbXmbxNXW0M6YFoPAgM/fx/3//
bzw., wenn man einen Freenet-Daemon am Laufen hat, hier:
http://127.0.0.1:8888/SSK@0OhVDWutibbBMbXmbxNXW0M6YFoPAgM/fx/3//
=head1 Und das ganze in Perl
Das ganze wäre relativ witzlos, wenn man nur irgendwelche
langweiligen Tools und/oder Java benutzen kann. Es gibt
zwei Perl-Module (bzw. Modulfamilien), C
(C) und C.
Ersteres ist älter (und vielleicht besser benannt) und konzentriert
sich mehr auf die Verarbeitung von Metadaten, ist aber recht schwach
beim eigentlichen Protokoll-Handling. Letzteres ist sehr gut beim
Protokoll-Handling und stark beim Kodieren und Dekodieren von Daten,
überläßt das Metadatenhandling aber dem Programmierer.
C stammt von mir und ist entstanden, weil ich das andere Modul,
die es nur im Freenet gab, nicht herunterladen konnte (tja, so ist das
eben als Freenetter). Daher gehe ich auch nur auf dieses Module ein :)
=head2 Installation
Zuerst braucht man einen Freenet-Daemon
(http://www.freenetproject.org/). Die Installation ist unglaublich komplex
(unter Windows gibt es einen Installer, unter Unix ein paar Skripte). Der
Daemon braucht eine Weile, bis er warm wird (Minuten bis Stunden), was man
durch Surf-Versuche unterstützen sollte.
Das C-Paket gibt es ganz normal per CPAN.
=head2 Einfache Abfragen
Die Abkürzung I steht für I und ist das
Protokoll zwischen Freenet-Anwedungen und dem Freenet-Daemon. Es ist
unglaublich ineffizient und noch dazu nicht verschlüsselt. Dies ist der
Grund für die Empfehlung, den Daemon nur auf dem lokalen Rechner laufen
zu lassen: Wäre dumm, wenn man aus dem hochsicheren Freenet über eine
ungesicherte Internetverbindung die Windows-Sourcen herunterlädt und
sicher erwischen läßt (ist alles schon vorgekommen)...
In Perl geht dies denkbar einfach:
use Net::FCP;
my $fcp = new Net::FCP;
Man kann dem Konstruktor von C direkt Namen und Port des
Freenet-Daemons übergeben. Üblicherweise holt er sich diese aber aus dne
Environment-Variablen C und C, die auf C<127.0.0.1>
bzw. C<8481> defaulten.
Übrigens wird nur eine virtuelle Verbindung aufgebaut. Möchte man
sicherstellen, daß tatsächlich ein Daemon erreichbar ist, kann man einen
C-Request ausführen oder einfach loslegen.
Im Normalfall heißt das also:: no configuration required.
Hat man ein C-Objekt, kann man schon alle Requests durchführen,
die man machen möchte:
my ($meta, $data) = @{ $fcp->client_get (
"freenet:SSK@0OhVDWutibbBMbXmbxNXW0M6YFoPAgM/fx/3//"
15
) };
Der C-Request erwartet zwei Argumente: eine Freenet-URI
(C<< freenet: >>) und eine HTL. Letztere muss man
nicht angeben, man sollte es aber, und vor allem sollte man dem Benutzer
die Wahl der HTL überlassen. Das dritte, optionale, Argument ist für
spezielle Anwendungen: am besten ignorieren.
Als Ergebnis erhält man immer eine Array-Referenz mit den Metadaten
und den Daten. Immer. Sollte ein Fehler auftreten wird eine Exception
ausgelöst (auf Perl: das Modul Cd). C hilft also im
Zweifelsfalle, für einfache Anwendungen ist das aber overkill.
Bricht das Programm ab, so sieht das folgendermaßen aus:
Net::FCP::Exception<>
Oder, wenn die Daten nicht gefunden wurden:
Net::FCP::Exception<>
Letzteres bedeutet übrigens nicht aufgeben, sondern nochmal versuchen,
z.B. mit einer höheren HTL. Ein fehlgeschlagener Versuch mit hoher HTL
bedeutet imemr noch nicht aufgeben. Daemons in der C<">NäheC<"> wissen nun,
das die Daten verlangt werden. Nach einiger Zeit ist es wahrscheinlich,
das die Daten auf einmal in der Nähe liegen: daher nie aufgeben, nochmal
probieren. Niemand hat behauptet, man bekäme die Daten einfach aus dem
Freenet wieder heraus...
Die Metadaten sind als Textdokument gespeichert. das Format
dieser Metadaten ist aber relativ C<">krankC<">, weshalb das Perl-Modul
einen Hash mit den geparsten Daten liefert (genaugenommen ein
C-Objekt, aber dieses Modul ist noch in Entwicklung).
Die Metadaten und die eigentlichen Nutzdaten kann man ausgeben:
use Data::Dumper;
print STDERR Dumper $meta;
print $data;
Damit haben wir im wesentlichen den Quelltext für das C<">ToolC<">
C, mit dem man I Freenet-Datenblock herunterladen kann.
Ich benutze es üblicherweise so:
eg/fetch1 SSK@0OhVDWutibbBMbXmbxNXW0M6YFoPAgM/fx/3// >data
Das schreibt die Daten in eine Datei und gibt gleichzeitig dessen
Metadaten aus.
Für den Key C ergibt dies:
'version' => { 'revision' => '1' },
'document' => [
{
'info' => { 'format' => 'image/png' },
'redirect' => { 'target' => 'freenet:CHK@pMKW...KAwI,7...-25C2w' },
'name' => 'activelink.png'
},
{
'info' => { 'format' => 'text/plain' },
'redirect' => { 'target' => 'freenet:CHK@2hew...KAwI,o...21z91w' },
'name' => 'description.txt'
},
{
'info' => { 'format' => 'text/html' },
'redirect' => { 'target' => 'freenet:CHK@kME~...QAwI,3...dy4OkA' },
'name' => 'index.html'
},
{
'info' => { 'format' => 'text/html' },
'redirect' => { 'target' => 'freenet:SSK@0OhV...PAgM/fx/4' },
'name' => '.next'
},
{
'info' => { 'format' => 'text/html' },
'redirect' => { 'target' => 'freenet:CHK@kME~...QAwI,3...dy4OkA' }
}
],
'raw' => 'Version
Revision=1
[... gekürzt...]
Info.Format=text/html
End
'
};
Die eigentlichen Daten sind leer (null Byte gross), das Dokument enthät
also nur Metadaten! Man beachte vor allem die teilweise recht tiefe
Verschachtelung.
Der Key C<< $metadata->{raw} >> enthält die Metadaten, wie sie vom
Freenet kamen. Dies ist notwendig, da man manchmal die Metadaten
zum Prüfen in der exakten Form benötigt, wie sie hochgeladen
wurden. Ansonsten kann man sie ignorieren.
Der Key C<< $metadata->{document} >> enthält Informationen über das
Dokument oder in diesem Fall die Dokumente: Ein Hash pro Dokument. Schaut
man sich den Inhalt an (ein Array), so sieht man in jedem Hash ein
C-Key, der den Namen des Subdokuments angibt (bis auf den letzten,
darauf komme ich gleich).
Schaut man sich dir Freenet-URIs dieser Freesite an, so sieht man
derartige URIs:
SSK@0OhVDWutibbBMbXmbxNXW0M6YFoPAgM/fx/3// # Hauptseite
SSK@0OhVDWutibbBMbXmbxNXW0M6YFoPAgM/fx/3//activelink.png # Icon
SSK@0OhVDWutibbBMbXmbxNXW0M6YFoPAgM/fx/3//description.txt # für Spider
Wenn diese Dokumente mit C anfordert, bekommt man immer obiges
Dokument. Freenet ignoriert nämlich alles, was hinter dem C steht
und liefert daher immer das gleiche Dokument aus dem SSK-Bereich. (Darauf
verlassen soltle man sich nicht unbedingt, in Zukunft reagiert der
Freenet-Daemon vielleicht anders. Als Freenetter hat mans eben nicht
leicht).
Der Teil hinter den beiden Slashes (C) ist nun das Unterdokument, das
man über den Namen identifizieren kann:
$activelink = grep $_->{name} eq "activelink.png",
@{ $metadata->{document} };
Fehlet der C-Eintrag ist es der Eintrag mit dem leeren Namen, in
diesem Fall der erste Link, der nichts nach den C stehen hat. Der
C-Key I vorhanden und leer sein: Freenet überprüft die Daten
nicht, daher gibt es durchaus unterschiedliche Auslegungen für das genau
Format.
Die Metadaten sind etwas genauer in dem *hüstel* etwas veralteten
*hüstel* I-Dokument beschrieben.
Möchte man nun das C herunterladen muss man in C<<
$activelink->{redirect} >> nachsehen. Meistens verweist dies auf ein
C-Schlüssel. Letztere sind sozusagen Allgemeingut: jeder kann
sie benutzen, und da sie nicht änderbar sind, kann sie auch niemand
fälschen, daher muss man sie nicht signieren.
Auf C<< $activelink->{info}{format} >> sollte man sich übrigens nicht
verlassen.
Und sollte kein C-Key vorhanden sein, so ist das Dokument im
mitgelieferten Datenblock. Alles ganz logisch, einfach, und klar, wie man
sieht.
Egal, der CHK-Key für C liefert folgendes:
'version' => { 'revision' => '1' },
Und die Daten stellen ein PNG dar. Naja, nicht gerade üppig, die
Metadaten, aber man hätt's ja im Link auf dieses Dokument sehen
können. Als Freenetter hat mans nicht leicht.
Aber mit diesen Erklärungen kann man schon einfacher Freenet-Spider
bauen. Die wichtigsten Tools sind veraltete und spärliche Dokumente
wie I und Tools wie C. C<">VeraltetC<"> ist
übrigens nicht immer schlecht, da viele Dokumente auch alt sind oder sich
eh' nicht exakt an den C<">StandardC<"> halten. Mit der Zeit wird hier sicher
eine Besserung eintreten.
=head2 Methoden des Freesite-Managements
Oder: C<">Wenn man Inhalte nicht mehr verändern kann, wie verändert man
sie?C<">
Die offensichtliche Methode ist: C<">Man macht sie veränderbarC<">. In
der Freenet-Gemeinde geistert seit langer Zeit der Mythos des
I-Schlüssels, des I
 =for latex
\begin{center}\includegraphics[scale=0.55]{freenet1.png}\end{center}
Die hier verwendete URL ist:
http://129.13.162.73:8888/...
...SSK@Sc6qV~D6iFhaYord6HtbjJ8MaEYPAgM/YoYo//Controversy.html
C